Credenciais de LLM viraram ativo de alto valor para atacantes. O risco quase nunca está no modelo. Está em como as empresas guardam, distribuem e delegam essas chaves.
Nesta semana, conversando sobre governança de IA com o Grupo de Estudos da ESA OAB/RS, o tema central foi Shadow AI: o uso de IA que a organização não enxerga. Existe um problema vizinho, bem menos comentado, que costuma aparecer primeiro onde ninguém está olhando: na fatura.
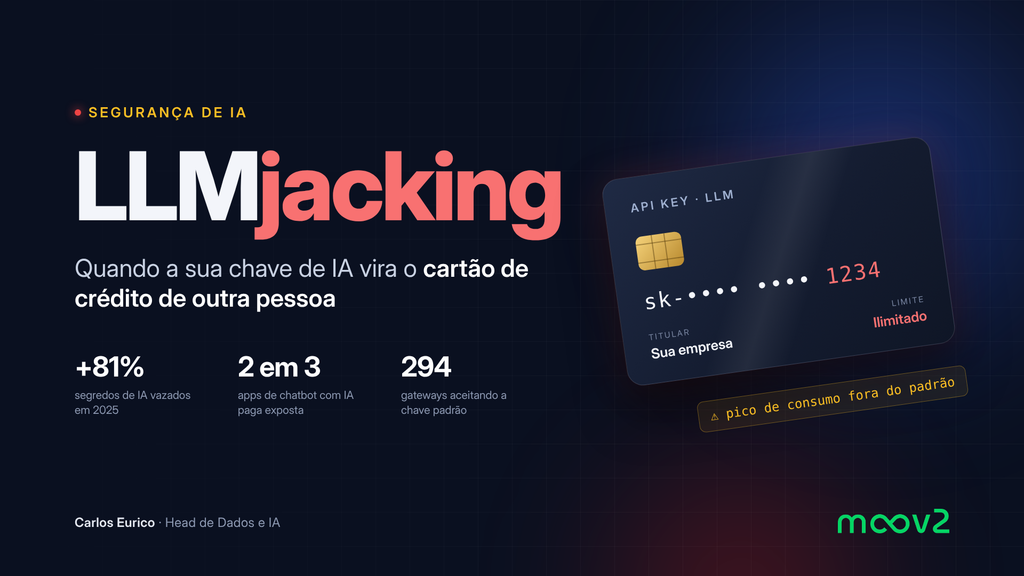
Uma chave de API da OpenAI, da Anthropic, do Azure OpenAI, do Gemini, do Bedrock ou do Hugging Face parece um detalhe técnico. Na prática, é um cartão de crédito corporativo com limite aberto para consumo de tokens e GPU. E esses cartões estão vazando em repositórios, pipelines de CI/CD, aplicativos móveis e gateways mal configurados.
O nome disso é LLMjacking.
O que é LLMjacking
É o sequestro do acesso a recursos de IA. O atacante obtém uma credencial válida (chave de API, access key de nuvem, token de serviço ou um endpoint exposto) e passa a consumir modelos e GPUs pagos em nome da vítima.
O objetivo central quase sempre é monetizar esse acesso. O atacante usa diretamente, revende como “API gratuita” no mercado criminoso ou monta um proxy que atende vários clientes usando credenciais de várias vítimas ao mesmo tempo. Roubar dados não é o objetivo principal, mas pode virar consequência.
Os números mostram que não é um risco teórico
- Repositórios: um levantamento da GitGuardian, citado pela Snyk, aponta crescimento de 81% em segredos de serviços de IA vazados em 2025. Tokens do Hugging Face, chaves do Azure OpenAI e credenciais do Weights & Biases estão entre os mais expostos. Só de chaves da DeepSeek, foram detectadas 113 mil.
- Aplicativos móveis: um estudo com 444 apps iOS de chatbot identificou que quase dois terços permitiam acesso não autorizado a serviços pagos de IA, em geral porque a chave do provedor estava embutida no próprio app.
- Gateways expostos: de 3.074 instâncias públicas do LiteLLM analisadas, 294 aceitavam a chave mestra padrão sk-1234 e 191 não tinham autenticação alguma.
- Cadeia de suprimentos: versões comprometidas do LiteLLM (1.82.7 e 1.82.8) foram associadas à exfiltração de segredos em ambientes de CI/CD, incluindo chaves de nuvem, tokens de repositório, chaves SSH, segredos Kubernetes e chaves de provedores de IA. Os relatórios falam em exposição potencial de cerca de 2.500 organizações e 434 mil pipelines.
O último caso merece atenção. A ferramenta que muitas empresas usam justamente para centralizar e controlar o acesso aos modelos virou o vetor do vazamento. Segurança de IA também é segurança de dependências.
Como o ataque acontece
O roteiro é previsível:
- Obtenção da credencial. Uma chave em repositório público, num arquivo .env, num log de CI/CD, na configuração de uma ferramenta de IA, numa máquina infectada por infostealer ou numa aplicação exposta na internet.
- Validação silenciosa. Chamadas de baixo volume para confirmar que a chave funciona e descobrir quais modelos, regiões e permissões estão disponíveis, sem disparar alertas.
- Enumeração. O atacante mapeia quotas e acessos: Bedrock, Azure OpenAI, Vertex AI, APIs da OpenAI e da Anthropic, endpoints internos ou servidores locais de inferência.
- Uso em escala. Alto volume de requisições, muitas vezes via proxies reversos, para esconder a origem e contornar limites.
- Monetização. Uso próprio, revenda ou proxy compartilhado.
Um exemplo concreto: um desenvolvedor comete uma chave da OpenAI num repositório público. Um bot de varredura encontra a chave em minutos. O atacante testa, confirma os modelos disponíveis e configura um proxy que repassa requisições de terceiros usando a chave da empresa. Centenas de pessoas passam a gerar texto, código e imagens. A fatura cresce, e o tráfego parece vir da aplicação legítima.
Existe ainda uma variação que não precisa de chave nenhuma: servidores de inferência local, como Ollama, expostos na internet. O atacante varre portas padrão, encontra o servidor aberto e coloca a GPU da vítima para trabalhar para ele.
Por que não é só um problema de custo
Uma chave de LLM raramente está isolada. Ela costuma estar ligada a contas de nuvem, cobrança corporativa, logs de uso, bases vetoriais, ferramentas de agentes e integrações internas.
Quando há permissão excessiva, o incidente muda de natureza. Na AWS, por exemplo, uma access key comprometida permite enumerar permissões, criar persistência, habilitar modelos e disparar inferência em várias regiões. O que começou como consumo indevido pode evoluir para acesso a dados, serviços internos e infraestrutura.
E com agentes e integrações MCP o risco se multiplica. Cada agente que recebe uma credencial ampla, compartilhada e sem rotação é mais uma porta.
Os sinais de alerta
Na maioria dos casos, o primeiro sinal de LLMjacking não vem do time de segurança. Vem do financeiro. Fique atento a:
- Pico repentino de tokens, chamadas de API ou custo, sem crescimento correspondente no negócio.
- Uso de modelos, regiões, horários ou países fora do padrão da aplicação.
- Tráfego vindo de IPs desconhecidos, proxies ou VPNs.
- Erros de quota, throttling e falhas de autenticação em volume.
- Criação inesperada de chaves, service accounts ou mudanças de IAM e de administradores de billing.
- GPU com uso contínuo em servidores de inferência interna.
A resposta: um ponto único de decisão
A defesa mais eficaz é arquitetural. Coloque um gateway de IA entre as aplicações e os provedores, e siga um princípio simples: nenhuma aplicação conhece a chave real do provedor.
As chaves reais ficam num cofre de segredos (AWS Secrets Manager, Azure Key Vault, HashiCorp Vault ou equivalente) e só o gateway as usa. Cada aplicação, equipe, agente ou integração recebe uma chave virtual própria, com:
- modelos e provedores permitidos;
- limite de custo e quota de tokens;
- rate limit por chave, usuário e IP;
- data de expiração;
- logs de identidade, modelo, tokens, custo e origem de cada chamada.
Na prática, fica assim:
- crm-prospeccao: só chat, modelos econômicos, até US$ 200 por mês.
- suporte-chatbot: chat e base de conhecimento, até 1 milhão de tokens por dia.
- agente-analise: chat e ferramenta SQL somente leitura, até US$ 500 por mês.
- dev-sandbox: modelos econômicos, US$ 50 por mês, sem acesso a produção.
Se uma dessas chaves vazar, o estrago tem teto. Um alerta em 70% do orçamento e bloqueio entre 90% e 100% transformam um incidente de cinco dígitos num aviso no painel.
E o gateway precisa ser tratado como ativo crítico: rede privada ou atrás de WAF, painel administrativo nunca exposto, MFA e allowlist de IPs para administradores, e nada de chave padrão. Os 294 servidores aceitando sk-1234 mostram que isso não é óbvio para todo mundo.
Checklist executivo
- Chaves apenas em backend ou cofre. Nunca em frontend, app mobile ou código distribuído.
- Chaves virtuais com escopo, quota e limite de custo, separadas por ambiente e finalidade.
- Rotação obrigatória (30 a 90 dias) e revogação imediata em caso de suspeita.
- Tokens de curta duração, OIDC e workload identity no lugar de credenciais estáticas.
- Gateway central com autenticação forte, rate limit e auditoria.
- Varredura contínua de repositórios, histórico Git, CI/CD, artefatos e logs.
- Alertas de custo, tokens, modelos e regiões anômalas, com logs de IA integrados ao SIEM.
- IAM com menor privilégio e MFA. Servidores locais de IA (Ollama, vLLM, LM Studio) ouvindo apenas em localhost.
Se a chave já vazou
- Revogue imediatamente a credencial suspeita.
- Rotacione todas as credenciais que compartilham origem, repositório, pipeline ou cofre.
- Bloqueie as origens maliciosas.
- Congele ou limite gastos no provedor e revise as faturas.
- Rastreie o alcance nos logs: modelos usados, dados enviados, ferramentas acessadas.
- Corrija a causa-raiz, não só o sintoma.
Para fechar
O LLMjacking quase sempre começa na identidade e na infraestrutura, não no modelo. Se uma credencial pode invocar IA sem limite, sem monitoramento e sem isolamento, ela é um cartão de crédito aberto.
Prevenir é reduzir a superfície de credenciais e limitar o poder de cada identidade. Detectar é perceber o desvio de consumo antes que a fatura, ou o incidente, cresça.
É a mesma lógica da governança de IA que discutimos no caso do Shadow AI: não basta proibir ou confiar. É preciso tornar o uso visível, controlado e auditável.
Uma pergunta para quem lidera tecnologia: hoje você sabe quantas chaves de IA existem na sua empresa, quem as usa e quanto cada uma pode gastar?